
絵を1枚、SNSやpixivに上げる。うれしい反応がつく一方で、ふと頭をよぎる不安があります。
- この絵、知らないうちに生成AIの学習データにされていないだろうか
- 自分の絵柄をまねたAIが、勝手に量産されたらどうしよう
- かといって、非公開にしたら仕事も趣味の発信も止まってしまう
この不安は、気のせいでも考えすぎでもありません。実際に、ネット上の大量の画像が同意なく学習に使われてきた経緯があり、描き手が身構えるのは当然のことです。
ただ、ここで先にお伝えしておきたいことがあります。結論から言うと、自分のイラストをAI学習から「100%守る」方法は、2026年の今も存在しません。
だからこそ大事なのは、できる対策を正しく知り、「何を・どこまで守るか」を自分の活動に合わせて設計することです。
この記事では、今日からできる具体策を手順で並べたうえで、それぞれの「効果と限界」を煽らず正直に書きます。
読み終わる頃には、やみくもに怖がるのではなく、落ち着いて手を打てるようになっているはずです。
- まず結論:「完全に防ぐ方法」は無い。だから“用途で濃淡を設計”する
- 対策の全体像|「表示を消す」と「学習させない」は別物
- ① 絵に仕込む:学習を妨害するツール(Glaze・Nightshade・Mist)
- ② 絵に仕込む:透かし・ノイズ・解像度(手軽だが効果は限定的)
まず結論:「完全に防ぐ方法」は無い。だから“用途で濃淡を設計”する
最初に、いちばん大事な前提を共有します。現時点で、公開した絵を生成AIの学習から確実に遮断する手段はありません。
学習を妨害するツールも、透かしも、サイト側の意思表示も、どれも「価値を下げる」「意思表示する」「一部を妨げる」にとどまり、完璧な盾にはならない——これは学習妨害ツールの開発元自身も認めている事実です。
がっかりさせたいわけではありません。むしろ逆です。「完璧に防ぐ」を目標にすると、非公開にするしかなくなり、発信も仕事も止まってしまう。
それでは本末転倒です。だから発想を変えます。
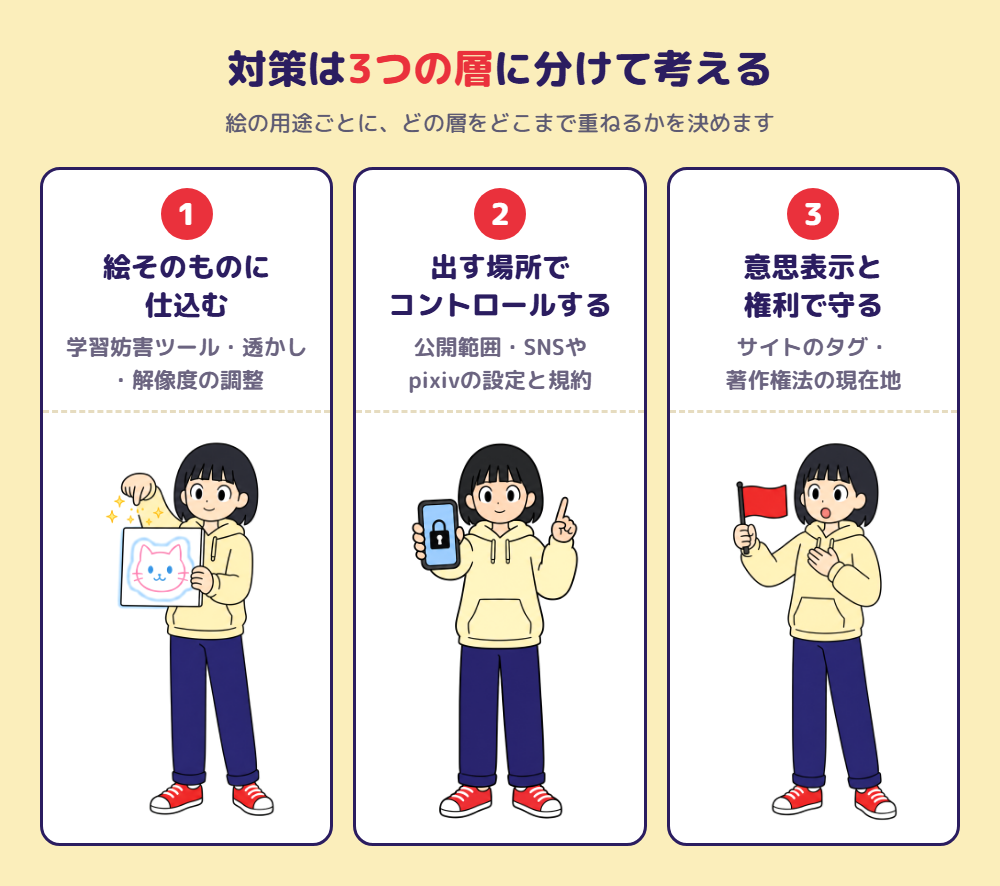
この記事で提案するのは、対策を3つの層に分けて、絵の用途ごとに「守りの濃淡」を設計するという考え方です。
- 絵そのものに仕込む対策……学習妨害ツール、透かし、ノイズ、解像度の調整
- 出す場所でコントロールする対策……公開範囲、各SNS・pixivの設定と規約
- 意思表示と権利で守る対策……サイト側のタグ、そして著作権法の現在地
趣味で楽しむ絵、集客のために見せる絵、お金をもらう納品データ——それぞれで「どこまで守るか」は変わります。
全部に最大の守りをかける必要はありません。順番に見ていきましょう。
対策の全体像|「表示を消す」と「学習させない」は別物
具体策に入る前に、つまずきやすいポイントを1つだけ整理します。「AIを非表示にする設定」と「自分の絵を学習させない対策」は、まったくの別物です。
たとえばpixivには、AIで生成された作品を自分の画面に表示しない設定があります。
これは便利ですが、あくまで「AI作品を“見ない”ための機能」であって、「自分の絵を“学習されない”ための機能」ではありません。
ここを混同すると、「設定したのに守られていない」と後でがっかりすることになります。
この記事で扱う対策は、効果の出方も、かかる手間も、絵への影響も、それぞれ違います。
全体像を1枚にまとめたのが次の図です。
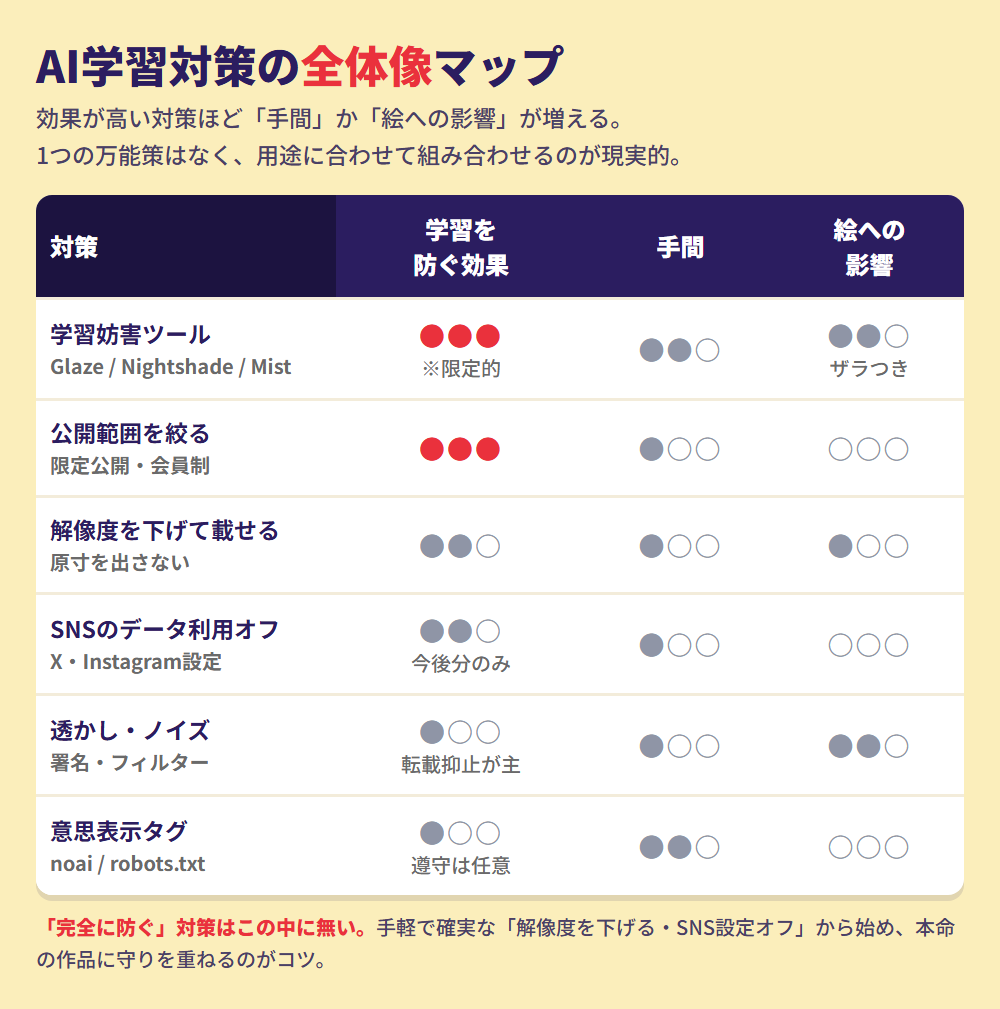
ポイントは、「効果が高い対策ほど、手間がかかるか、絵の見え方に影響する」という傾向があることです。
たとえば学習妨害ツールは効果が期待される一方で処理に時間がかかり、絵によっては微妙なザラつきが出ます。
逆に、SNSの設定変更は手軽ですが、守れる範囲は限定的です。だからこそ、1つの万能策を探すのではなく、複数を組み合わせて用途に合わせるのが現実的です。
この図を頭の片隅に置きながら、1つずつ見ていきましょう。
① 絵に仕込む:学習を妨害するツール(Glaze・Nightshade・Mist)
まずは、絵そのものに「AIが学習しづらい加工」を施すツールです。代表的なものが3つあります。
いずれも、人の目にはほぼ分からない微細なノイズ(摂動)を画像に加えて、AIの学習を妨げる仕組みです。
- Glaze(グレーズ)……アメリカのシカゴ大学の研究チームが開発した防御ツール。画風をまねる「スタイル学習」を、AIに別の画風だと誤認させることを狙います。無料。
- Nightshade(ナイトシェード)……同じチームの攻撃(データ汚染)ツール。学習に取り込まれると「犬を猫と覚える」ように概念を壊すことを狙います。無料。
- Mist(ミスト)……Glazeと近い発想の、先行する敵対的ノイズツール。スタイル模倣の防止が目的です。
「それなら全部かければ安心」と言いたいところですが、効果には注意すべき限界があります。
正直にお伝えします。
- 完璧ではない、と開発元が明言している。将来の新しい手法で突破されうること、恒久的な解決策ではないことを、公式が自ら認めています。
- Nightshadeは「1人では効きにくい」。自分1枚を汚染するだけでは効果の閾値に届かず、多くの描き手が参加して初めて抑止力になるとされます。個人の護身というより、集団での対抗手段に近い性質です。
- 加工が破られる・劣化する可能性。学術研究では、トリミングや再圧縮、単純な回避手法で保護が弱まりうると報告されています(参考:敵対的摂動はアーティストを確実には守れない、という研究(arXiv))。平らで滑らかな背景では、加工のザラつきが見えやすいという弱点もあります。
まとめると、学習妨害ツールは「かけておく価値はあるが、万能ではない」という温度感が正確です。
本命の作品に Glaze をかけておくのは合理的な自衛ですが、「これをかけたから絶対に安全」とは考えないことが大切です。
導入は各ツールの公式サイト(Glaze公式など)から行えます。NightshadeもGlazeと同じシカゴ大学のプロジェクトで、公式サイトから入手できます。
② 絵に仕込む:透かし・ノイズ・解像度(手軽だが効果は限定的)
ツールほど大がかりでなく、描き手が手早くできる定番の対策もあります。ただし、これらは学習そのものを止める力は弱く、「無断転載・無断利用をしにくくする」効果のほうが中心だと理解しておくのが大事です。
ウォーターマーク(透かし)
署名やロゴ、サイン、サイト名などを絵の上に重ねる方法です。無断転載への抑止力になり、拡散したときの出所の証明にもなります。
ただし、透かしを入れても学習自体は止められませんし、画面全体に薄く重ねると作品としての見栄えが落ちます。
見える場所に小さく、絵の主役を隠さない位置に——が現実的な落としどころです。
ノイズ・フィルターをかける
画像全体に薄いノイズやフィルターを加える方法です。学習の精度を少し下げる狙いがありますが、強くかけると絵が汚れて見え、弱いと効果も薄い、というトレードオフがあります。
解像度を下げてアップする
高解像度の原寸データをそのまま公開せず、Web表示に必要な範囲まで縮小して載せる方法です。
これは手軽でおすすめできる基本動作です。学習を防ぐというより、高画質な原データを不特定多数に渡さないという素朴で確実な自衛になります。
入稿用の原寸データは、そもそもネットに上げないのが鉄則です。
この層の対策は、どれも「決定打」ではありません。しかし、手間が軽く絵への影響も小さいものは、やっておいて損がない——そういう位置づけで取り入れるのがちょうどよい距離感です。
③ 出す場所で守る:公開範囲とpixivの設定・規約
絵への加工に加えて、「どこに・どこまで見せるか」をコントロールするのも立派な対策です。
公開範囲を絞る
フォロワー限定、会員制、パスワード付き、R-18区分など、不特定多数のクローラーが自動で拾いにくい場所に置くほど、学習データに取り込まれるリスクは下がります。
全作品を鍵付きにする必要はありませんが、「これは絶対に学習されたくない」という本命は、公開範囲を絞るだけでも守りが一段上がります。
pixivの規約と設定を正しく理解する
pixivは2023年5月の規約改定で、投稿作品を情報解析(AIの学習など)した結果を、投稿者の不利益になる形で用いる行為を、許諾なく行うことを禁止しました(参考:pixiv公式のお知らせ)。
禁止の対象は「学習そのもの」ではなく「解析結果を投稿者の不利益になる形で使うこと」である点は、正確に押さえておきましょう。
これは描き手にとって心強いルールです。
ただし、前の節でも触れたとおり、pixivの「AI生成作品を表示しない」設定は、自分の絵を学習させない機能ではありません。
規約(ルールとして禁止する)と、技術的な拒否(そもそも取り込ませない)は別のレイヤーだ、と覚えておいてください。
画像単位で学習を拒否したい場合は、外部の意思表示サービスやブラウザ拡張を併用することになります。
④ データ利用をオフにする:X(Grok)とInstagram(Meta)の設定
見落とされがちですが、SNS自体が、あなたの投稿を自社AIの学習に使っている場合があります。
これは設定でオフにできることが多いので、必ず確認してください。※各社の設定画面や文言は改定が続いているため、最新の表記はアプリ内の公式ヘルプで確認してください。
X(旧Twitter)のGrok向けデータ利用
Xでは2024年7月、AI「Grok」の学習に投稿を使う設定が、初期状態でオンのまま追加されていたことが明らかになりました。
オフにする手順の目安は次のとおりです。
- 設定とプライバシー → プライバシーと安全 → Grokと連携パートナーに進み、学習・ファインチューニングへの利用を許可するチェックを外す。
注意点として、オフにできるのは「今後の利用」だけで、過去にさかのぼって削除されるわけではありません。
また、オフにしても公開投稿そのものが外部に見えている事実は変わりません。
Instagram・Facebook(Meta)の生成AI学習
Metaも、Instagram・Facebookなどの公開投稿を生成AIの学習に使う方針です。
重要なのは地域差で、EU・英国に加えて、日本には異議申立て(オプトアウト)の権利があります。
Metaのプライバシー設定から「異議申立て(Right to Object)」のフォームで申請する形で、申請が通れば今後の利用を止められます(手順の一般的な解説:オプトアウトのやり方(MIT Technology Review)。
対象地域や手続きは変わるため、最新はMeta公式で確認してください)。アプリ内のワンタップではなく、やや手間のかかる申請形式になっている点は、知っておくとよいでしょう。
⑤ サイト・ポートフォリオ側で意思表示する(noai・robots.txt)
自分のサイトやポートフォリオで絵を公開している人は、「このページ・画像を学習に使わないでほしい」という意思表示をコードで添えることができます。
- noai / noimageai……ページのメタタグやサーバーの応答ヘッダに付けて、学習利用を拒否する意思を示すディレクティブ。イラスト投稿サイトのDeviantArtが2022年に導入し、広まりました。
- robots.txt でクローラーを拒否……学習用にネットを巡回するクローラー(OpenAIのGPTBot、Googleの Google-Extended、Common CrawlのCCBotなど)を名指しでブロックする記述を置く方法です。
ただし、ここでも限界を正直に書きます。これらはあくまで「お願い」であり、守るかどうかは相手しだいです。
一部のクローラーは尊重しますが、すべての事業者が従う保証はなく、法的な強制力はありません。
「鍵をかける」のではなく「貼り紙を出す」イメージです。それでも、意思表示をしておくこと自体に意味はあります。
従う事業者には効きますし、文化庁の考え方でも、robots.txt のような機械が読める方法での措置は、権利者が自由に行えるものとして触れられています。
⑥ 法律はどこまで守ってくれるのか(文化庁2024の考え方)
「そもそも法律で守られないの?」という疑問に、2026年時点の正確なところを書きます。
ここは誤解が多く、煽られやすい部分なので、落ち着いて読んでください。
日本では2024年3月、文化庁が「AIと著作権に関する考え方について」をまとめました。
ポイントは次のとおりです。
- 学習させる段階は、原則として著作権者の許可なく行える。情報解析など「作品を“楽しむ”ことを目的としない利用」は、著作権法30条の4で広く認められています。残念ですが、ここが出発点です。
- ただし「享受(楽しむ)目的」が併存すると、この例外は使えません。とくに、ある特定の作家の作品だけを集中的に学習させる・過学習させる・作風特化のLoRAを作るなど、その人の表現そのものを出力させる狙いがある場合は、侵害になりうると整理されています。
- 守られるのは「作風・画風」そのものではなく、「具体的な創作的表現」です。画風やアイデアは著作権の保護対象外というのが大原則。「絵柄をまねされた」だけでは法的に争うのは難しい一方、具体的な絵をそのまま複製・改変されれば、著作権侵害を問える可能性があります。
補足すると、この「考え方」は新しい法律ではなく、現行法の解釈を整理したガイドラインです。
学習は原則OKという土台の上で、侵害の線引き(特定クリエイターへの集中・過学習など)は個別判断になり、裁判や立法を含めた議論は今も進行中です。
「法律が全部守ってくれる」でも「無法地帯」でもなく、“守られる範囲と守られない範囲がある”——これが正確な現在地です。
自分の権利を落ち着いて主張できるよう、契約や二次利用の基本を押さえておくことも、立派な自衛になります。
⑦ よく聞く「イラストのAI学習対策」は本当に効く?|巷のノウハウ14個を判定
SNSやブログには、「GIFにすれば学習されない」「反転させれば大丈夫」といったAI学習対策のノウハウがたくさん出回っています。
中には理にかなったものもあれば、やっても学習の流れにはほとんど関係しない“誤解”も混ざっています。
そこで、よく聞く対策を14個集め、学習データの集め方・使い方の仕組み(収集ツールや学習プログラムの公式資料、研究論文、文化庁の考え方)に照らして判定しました。
判定は「効く」「一部効く」「ほぼ効かない」の3段階です。なお、ここでの「効く」は完全に防げるという意味ではありません。この記事の前提どおり、100%の盾は存在しません。
| よく聞く対策 | 判定 | 理由 |
|---|---|---|
| GIFアニメ・APNG(動く画像)にする | ほぼ効かない | 学習用の画像処理では、動く画像も開いた時点で1コマ目の静止画として扱われるのが一般的です。1コマ目に絵が映っていれば、ふつうの画像と同じように取り込まれえます。 |
| 左右反転・色反転して載せる | ほぼ効かない | 左右反転は、学習の際にAI側があえて行う「水増し」の定番処理で、妨げになりません。色反転も一手で元に戻せる加工で、守れると確かめられた根拠はありません。 |
| 絵を分割して並べる(タイル状の投稿) | ほぼ効かない | 分割した1枚1枚が、ふつうの画像として集められるだけです。学習側には画像の一部を切り出して使う処理が標準で備わっており、分割で守れると確かめられた根拠はありません。 |
| 全面に透かし・斜線・格子を重ねる | 一部効く | 透かし入りの画像を自動で見分けて学習から外す選別が、一部のデータセットやモデルで実際に使われています。ただし選別するかどうかは相手しだいで、絵の見栄えも大きく落ちます。 |
| 薄いノイズ・フィルターを自分でかける | ほぼ効かない | Glazeなどが効くのは、AIの読み取り方に合わせて計算した加工だからで、ランダムなノイズにその仕組みはありません。研究ではむしろ、ノイズを足す処理が「保護を外す側」の下ごしらえとして使われています。 |
| 解像度を下げる・サムネだけ載せる | 一部効く | 高解像度の画像だけを選んで学習した例があり、小さい画像はそうした選別で外れることがあります。ただし収集ツールの初期設定では小さい画像も集められるので、「原寸を渡さない」効果が中心です。 |
| 右クリック禁止・保存禁止にする | ほぼ効かない | 学習用の収集は、ブラウザの右クリックではなく、画像のURLから直接ダウンロードする仕組みです。人の手による保存をためらわせる程度の効果にとどまります。 |
| プロフィールや絵に「AI学習禁止」「No AI」と書く・#NoAIタグを付ける | ほぼ効かない | 画像やプロフィールの文字は、収集ツールが判定に使う「機械向けの指示」ではありません。文化庁の考え方でも、反対の意思表示があることだけで扱いが変わるとは考えられない、と整理されています。 |
| 画像のメタデータ(EXIF・IPTC)に「学習禁止」と書く | ほぼ効かない | 「学習禁止」を書き込む欄は規格として用意されていますが、守るかどうかは相手しだいです。学習の現場で広く尊重されていると確かめられた根拠はありません。 |
| C2PA(Content Credentials)を付ける | ほぼ効かない | C2PAは「誰がどう作ったか」の来歴を記録する仕組みで、学習の可否は対象外だとC2PA自身が明言しています。学習拒否の項目は別団体による拡張で、こちらも意思表示にとどまります。 |
| 自分のサイトに noai・robots.txt を設定する | 一部効く | 代表的な画像収集ツールは noai の指示が付いた画像を初期設定で除外し、大規模クローラーの Common Crawl も robots.txt に従うと明言しています。ただし、従うかどうかは事業者しだいです。 |
| 鍵アカ・フォロワー限定で公開する | 一部効く | ログインせずに巡回する外部のクローラーからは見えにくくなります。ただし、SNS運営会社自身のデータ利用は設定と規約しだいで、閲覧できる人が保存する可能性も残ります。 |
| Caraなど「AI学習お断り」を掲げるSNSへ移る | 一部効く | 運営会社自身が学習に使わない、という点では意味があります。ただしCara自身が、規約で禁止していても大規模な無断収集の被害を受けたと公表しています。 |
| Glaze・Nightshadeなどの学習妨害ツールをかける | 一部効く | 画風の模倣を妨げる効果が期待できる、数少ない「絵そのものに効く」対策です。一方で、簡単な処理で効果が弱まることも研究で示されています(①で解説)。 |
「GIFアニメにすれば学習されない」は誤解
いちばんよく聞くのがこれですが、学習の流れを見るかぎり、GIFにしても守りにはなりません。
学習用の画像を扱う代表的なプログラム(Pythonの画像ライブラリPillow)は、動く画像を開くと自動的に1コマ目の位置で読み込む仕様です。
画像生成AIの学習プログラムの例でも、読み込んだ画像を1枚のカラー画像に変換してから学習に回しており、ネット上の画像を大量に集めるツールも、1枚の画像として読み込む作りになっています。
つまり、1コマ目にイラストが映っていれば、それはふつうの静止画と同じように素材になりえます。
しかもGIFには、1枚の中で使える色が最大256色という制限があります。
グラデーションや繊細な塗りは荒れやすく、守りにならないうえに絵の見栄えだけ落ちる、という損な対策になりがちです。
さらに、学習妨害ツールのGlazeは JPGとPNG にしか対応していないため、GIFにすると本当に意味のある加工をかけにくくなるという逆効果もあります。
では、「1コマ目だけ何も描いていない白にしておけば、学習されないのでは?」と考える人もいるかもしれません。
理屈の上では、初期設定どおり1コマ目だけを読み込む仕組みからは「何も描いていない画像」に見えるので、外れる可能性はあります。
ただし、守りとしてはおすすめできません。理由は4つです。
- 2コマ目以降は簡単に取り出せる……1コマ目だけを読むのはあくまで初期設定の動きで、動く画像や動画からコマを切り出して集めるのはごく普通の処理です。
- 投稿先で形が変わることがある……SNS側で別の形式に変換されたり、静止画のサムネイルが作られたりすると、仕掛けが残る保証はありません。
- 同じ絵を静止画で載せた時点で意味がなくなる……ポートフォリオやpixivに普通の画像で出していれば、そこから集められます。
- 代償が大きい……256色の制限で塗りが荒れ、Glazeもかけられず、見る人には最初に白い画面が映ります。
この方法で学習を防げると確かめた研究や公式の資料も、見つかっていません。
「本気で集める相手には効かず、絵の見栄えだけが落ちる」と考えておくのが正確です。
「AI学習禁止」と書くだけでは、学習も法律上の扱いも変わらない
プロフィールや絵の隅に「AI学習禁止」「No AI」と書くのも定番ですが、これは人に向けた意思表示であって、自動で画像を集める仕組みを止めるものではありません。
収集ツールが判定に使うのは、サイトの noai 指定や robots.txt のような「機械向けの指示」です。
法律面でも、文化庁の「AIと著作権に関する考え方について」は、著作権者が反対の意思を示していることそれ自体をもって、権利制限規定の対象から除外されると解釈することは困難だとしています。
一方で同じ資料は、robots.txt のような機械が読める方法での措置については、権利者が自由に行えるものとして言及しています。
文字で書く意思表示は、見た人への抑止にはなります。ただ「書いたから守られる」とは考えず、機械向けの設定と組み合わせるのが正確な使い方です。
透かし・低解像度は「選別で外れることがある」程度の効き方
透かしと低解像度が「一部効く」なのは、学習データを作る側が品質の選別をかけることがあるからです。
たとえば、大規模な画像データセットのLAION-5Bには、透かしが入っている可能性を示すスコアが付いています。
Stable Diffusion(初期の版)の公式の説明にも、透かしの可能性が高い画像や、一定サイズより小さい画像を除いたデータで学習したと書かれています。
ただし、こうした選別をするかどうか、どこで線を引くかは相手しだいです。
画像を集めるツール自体は、初期設定では小さい画像も透かし入りの画像も集めます。
「入れておけば学習されない」ではなく、「選別で外れることもある」くらいの期待値で考えておくのが正確です。
こうして並べると、手軽にできるノウハウほど「ほぼ効かない」に寄り、意味のある対策ほど「一部効く」にとどまることが分かります。
だからこそ、1つの裏ワザに頼るのではなく、効き方の分かっている対策を、絵の用途に合わせて組み合わせることが大切です。
次の章で、その「守りの濃淡」の付け方を具体的に見ていきましょう。
⑧ 仕事を止めずに守る|用途別「守りの濃淡」の設計
ここまでの対策を全部やろうとすると、手間で疲れてしまいます。そこで最後に、イラストを仕事や発信に使い続けながら、現実的に守るための“濃淡の設計”を提案します。
絵を3つの役割に分けて考えるのがコツです。
- 集客・宣伝のために見せる絵(露出を優先)
フォロワーを増やし、仕事につなげるための絵は、たくさんの人に見られてこそ価値が出ます。ここで守りを固めすぎると本末転倒。解像度を下げる・小さく署名を入れる程度の軽い守りにとどめ、露出を優先します。 - 本命の作品・ポートフォリオ(守りを一段上げる)
自分の代表作や、画風が特に出ている作品は、学習妨害ツール(Glaze)+解像度の調整+意思表示を重ねておきます。手間はかかりますが、まねされて困る度合いが高いぶん、かける価値があります。 - お金をもらう納品データ(絶対に外に出さない)
クライアントに渡す原寸・高解像度のデータは、そもそも学習経路になりうる場所に公開しないのが最大の対策です。SNSやポートフォリオに載せるのは縮小版だけにし、原データはクライアントとの受け渡しの中だけで扱います。これは加工よりも確実な守りです。
この「濃淡の設計」なら、発信も仕事も止めずに、守るべきところを守れます。完璧を目指して萎縮するより、活動を続けながら合理的に自衛する——それが、長く絵で食べていくうえでの現実解です。
AIとの向き合い方そのものに悩んでいるなら、守りだけでなく「これからどう活動を続けるか」まで視野を広げておくと、不安に飲まれずに済みます。
よくある質問
GlazeやNightshadeをかければ、もう学習されませんか?
「絶対に学習されない」とは言えません。開発元自身が「完璧ではなく将来の手法で破られうる」と明言しており、トリミングや再圧縮で効果が弱まる可能性も研究で指摘されています。
本命の作品にかけておく価値はありますが、万能の盾とは考えないほうが安全です。
すでに投稿した絵は、もう手遅れですか?
過去に公開した絵が学習に使われたかどうかを個人が完全に確認・取り消すのは困難です。
ただし、今後の投稿から対策する意味は十分あります。SNSのデータ利用設定も「今後の利用」を止めるものなので、早めにオフにしておくほど効きます。
絵柄(画風)をまねされたら、著作権で訴えられますか?
作風・画風そのものはアイデアとされ、著作権の保護対象外というのが原則です。一方で、具体的な絵をそのまま複製・改変された場合や、特定の作家に集中した学習・出力が行われた場合は、侵害を問える可能性があります。
ケースによるので、深刻なときは専門家への相談が確実です。
結局、何から手をつければいいですか?
まずは手軽で効果が確実なものから。「①原寸データをネットに上げない(解像度を下げる)②X・Instagramのデータ利用設定をオフにする」の2つは今日できます。
そのうえで、本命の作品にGlazeをかける・公開範囲を絞る、と段階的に足していくのがおすすめです。
非公開にすれば完全に安全ですが、それだと活動できません。どうすれば?
だからこそ「用途別の濃淡」です。集客用の絵は露出を優先して軽い守りに、本命作品は守りを厚く、納品データは外に出さない。
全部を最大の守りで固める必要はありません。活動を止めずに、守るところを選んで守りましょう。
まとめ|怖がるより、知って設計する
自分のイラストをAI学習から100%守る方法は、2026年の今もありません。けれど、できる対策は確かにあり、それを正しく知って用途ごとに設計すれば、活動を止めずに守りを固められます。
要点を振り返ります。①完璧な盾は無い。だから用途で守りの濃淡を設計する ②「表示を消す」と「学習させない」は別物 ③学習妨害ツール・透かし・解像度・公開範囲・SNS設定・意思表示・法律を組み合わせる ④効果の限界も正直に理解する——この4つを押さえれば、やみくもな不安からは抜け出せます。
いちばんの敵は、「どうせ防げない」とすべてをあきらめることでも、「完璧に守らなきゃ」と萎縮して筆を止めることでもありません。
知ったうえで、自分の活動に合わせて落ち着いて手を打つこと。今日できるのは、原寸データを上げない設定と、SNSのデータ利用オフから。
まずはそこから始めてみてください。
この記事のテーマを深めるなら、手元に置いておきたいもの。